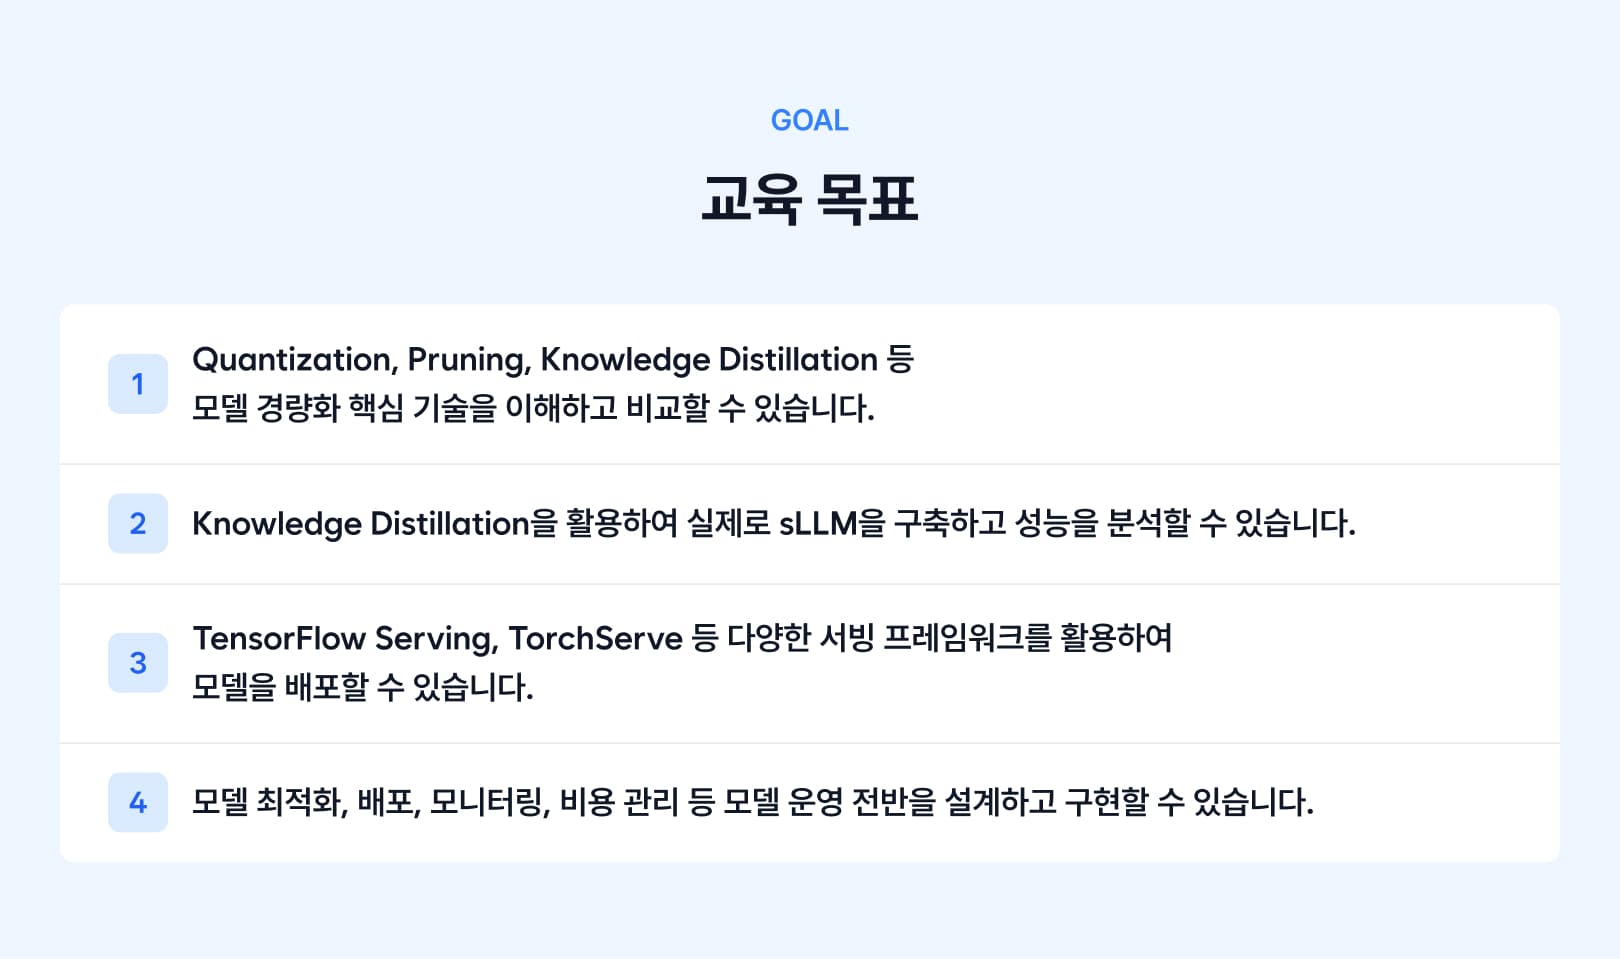
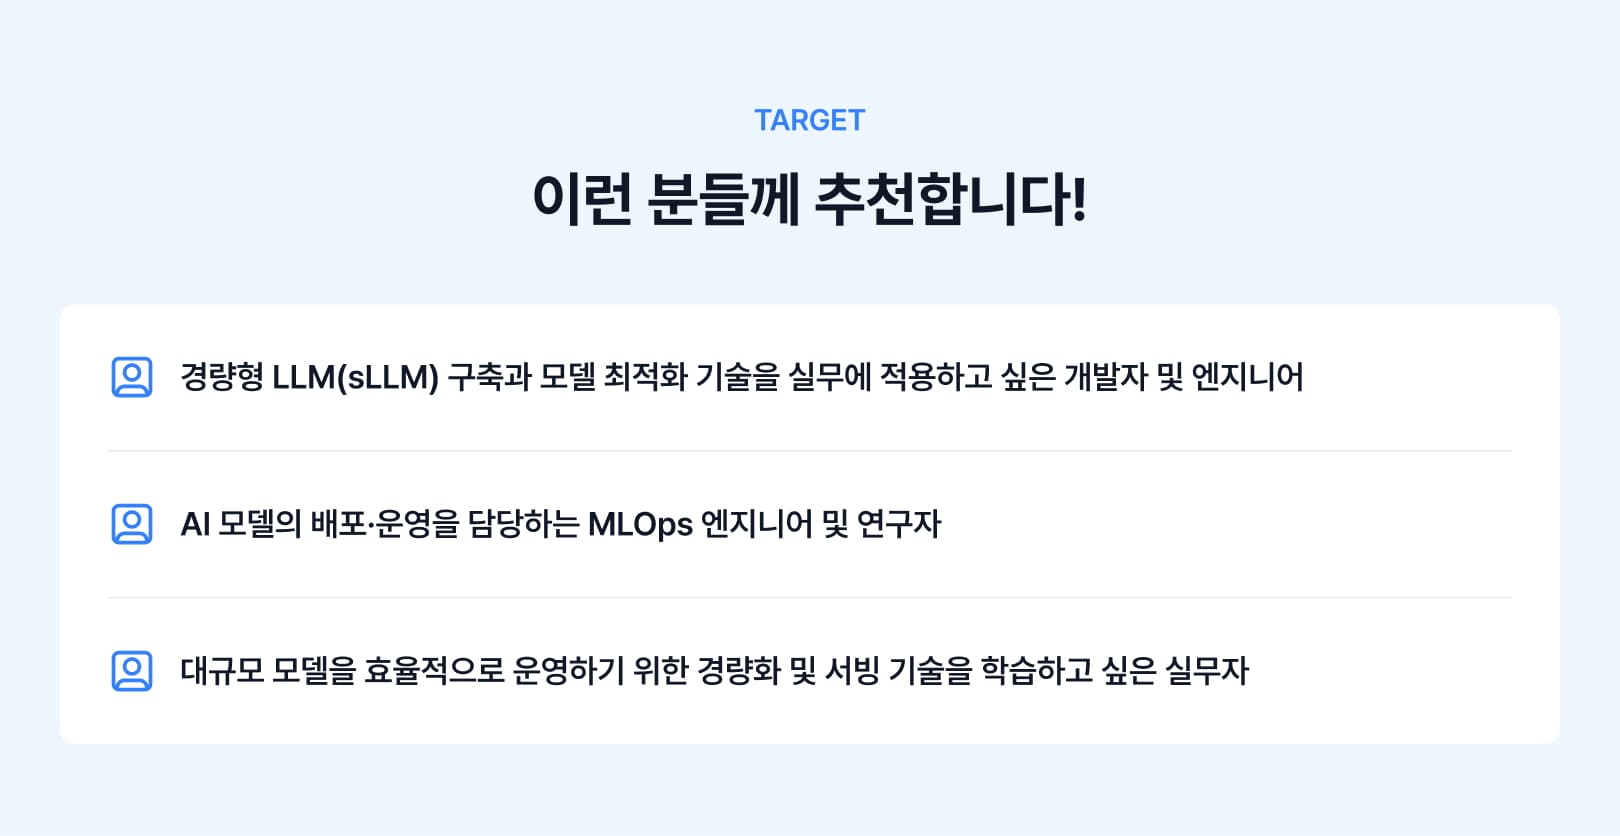
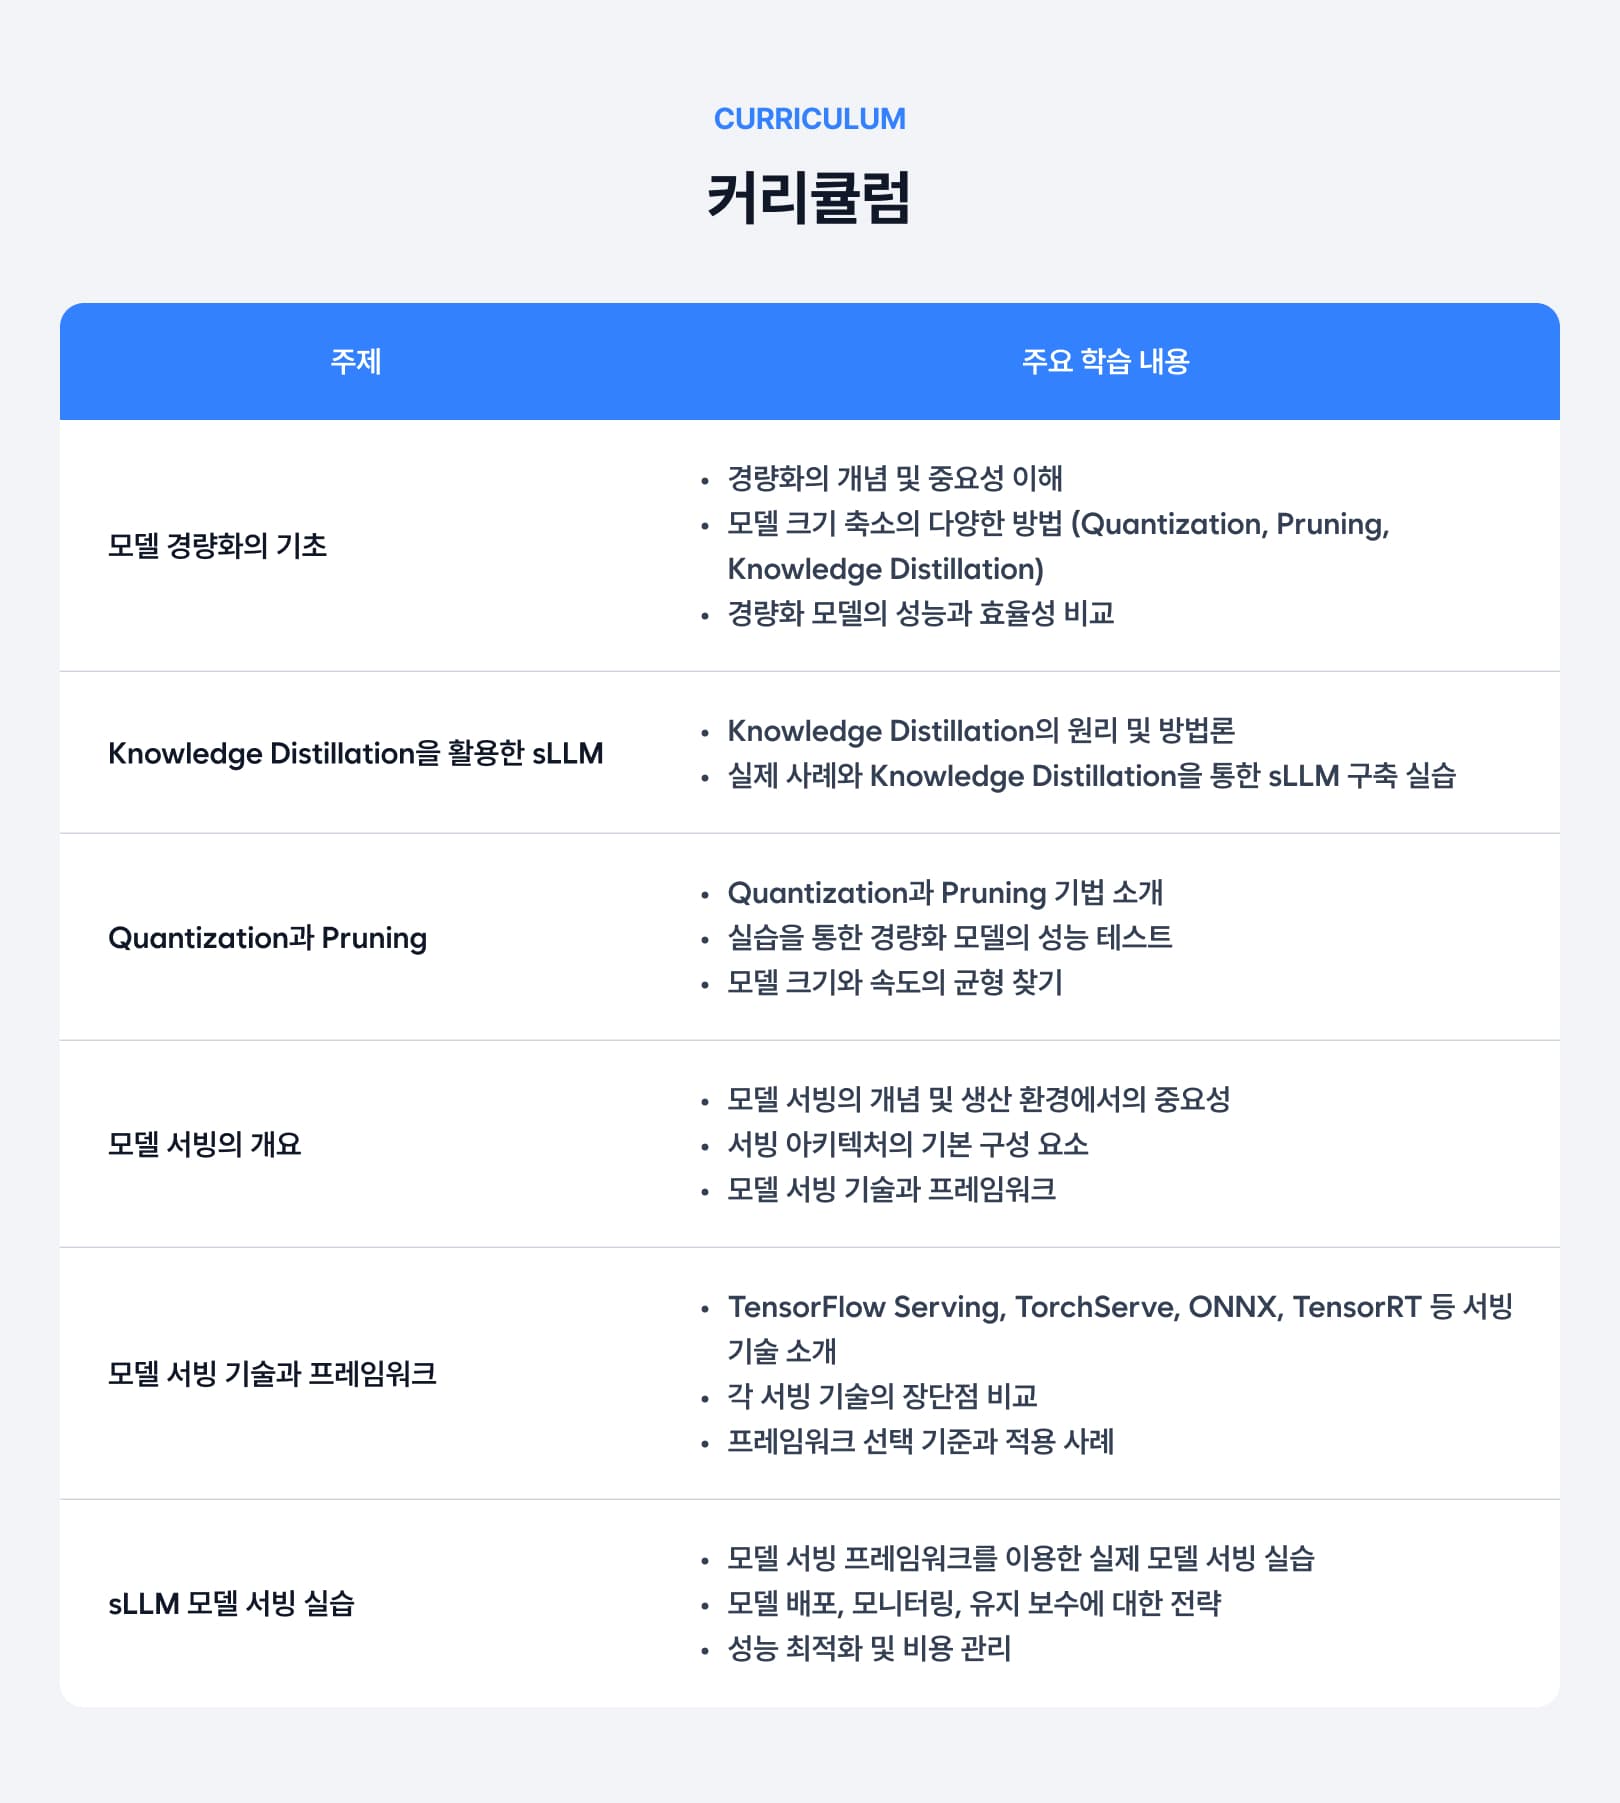
비용 효율과 처리 속도를 높이는 sLLM 모델 경량화와 서빙 기술을 배우는 실전 과정입니다. Quantization·Pruning·Knowledge Distillation 등 모델 최적화 기법을 비교·적용해 sLLM을 구축하고 성능을 분석하며, TensorFlow Serving·TorchServe 등 서빙 도구로 경량화 모델을 배포·운영하는 방법을 익힙니다.